Связаться с редакцией


Кибератаки утвердились в статусе главного риска для непрерывности бизнеса. В 2025 году они впервые обошли ИТ-сбои (42% против 33% инцидентов) на российском рынке, показало исследование команды Jet Security компании «Инфосистемы Джет». В то же время опасно недооценивать все остальные угрозы, которые никуда не исчезли. Локальные отказы оборудования, природные катаклизмы и техногенные сбои, вызванные в том числе ошибками персонала, — эти события по-прежнему способны парализовать компанию за считанные минуты. Полностью защититься от инцидентов нельзя. А что можно? Оценить возможные последствия и сделать выход из критической ситуации предсказуемым, плавным и менее стрессовым. Как из потенциальных угроз рождаются конкретные цифры, а из цифр — четкие инструкции, читайте в материале.
Угрозы непрерывности бизнеса в разных отраслях
Эксперты программного комитета конференции IT Elements 2026 назвали главные риски для непрерывности бизнеса. Их перечни оказались похожими по составу угроз, но разными по расстановке приоритетов.
Киберугрозы: от фишинга до атак через поставщиков
Киберинциденты могут привести к компрометации данных, недоступности сервисов, нарушению производственных процессов и даже к полному уничтожению ИТ-инфраструктуры. Защититься на 100% от ИБ-угроз сегодня невозможно, при этом мотивы злоумышленников меняются: финансовая выгода все чаще уступает место хактивизму — политически мотивированным деструктивным атакам. Эксперты из разных отраслей ставят киберугрозы на первое место среди рисков.
«Отраслевая статистика по авиации и аэропортам в целом фиксирует ощутимый рост числа и сложности инцидентов за последний год. Атаки становятся более точными и часто связаны не только с финансовыми убытками, но и с репутационными потерями».
Сергей Левашов,
заместитель генерального директора по ИТ и цифровой трансформации Государственного научно-исследовательского института гражданской авиации
DDoS-атаки и программы-вымогатели не знают отраслевых границ — с ними сегодня сталкиваются все сегменты бизнеса. Финансовый сектор принимает на себя около трети всех DDoS‑атак, и они постоянно эволюционируют, отмечает Александр Тоцкий. Для промышленности одним из главных рисков становятся вирусы-шифровальщики, указывает Андрей Абашев. А в авиации наблюдается резкий рост активности обоих типов атак, констатирует Сергей Левашов.
Вместе с тем сразу несколько экспертов подчеркнули, что атаки все чаще совершаются не напрямую, а через подрядчиков или поставщиков.
Одним из основных векторов проникновения злоумышленников в инфраструктуру компаний, вне зависимости от отрасли, остаются фишинг и другие приемы социальной инженерии. Эта тенденция подтверждается и на глобальном уровне: согласно отчету Verizon 2025 Data Breach Investigations Report (DBIR), на долю внешних угроз, социальной инженерии и атак на веб-приложения приходится 96% всех утечек данных. При этом, как показывают сразу несколько международных исследований, фишинговые письма чаще всего генерируются ИИ.
«В нашей компании практикуется принцип zero trust, используется обязательная двухфакторная аутентификация, выполняются ежемесячные тестовые фишинговые рассылки. Один сотрудник все же попался — теперь учим всех на его ошибках, а не прячем голову в песок».
Антон Клочков,
руководитель направления отдела разработки архитектурных решений компании «Базис»
Впрочем, человеческий фактор проявляется и в типичных ошибках администрирования — например, когда инженер открывает порт в интернет ради удобства, без согласования со службой ИБ.
Важно учитывать, что на практике ИБ-угрозы часто пересекаются и комбинируются, образуя комплексные векторы атак, напоминает Андрей Абашев. Так, социальная инженерия запускает целый каскад: обман сотрудника → компрометация цепочки поставок → атака на бизнес-процесс → атака на производственный процесс.
«Подобная каскадность и взаимное усиление угроз делают непрерывность бизнеса критически важной дисциплиной: система управления непрерывностью должна учитывать не просто отдельные инциденты ИБ, а комплексные сбои, затрагивающие одновременно людей, процессы, технологии и внешних партнеров. Такая система должна обеспечивать восстановление критически важных функций на приемлемом уровне и в согласованные сроки».
Андрей Абашев,
директор по развитию функции ИБ, департамент защиты информации и ИТ-инфраструктуры компании «Норильский никель»
Технические сбои и масштабные ИТ-инциденты
Технические сбои — еще одна группа рисков. В сложной экосистеме, такой как современный банк, отказ одного компонента способен повлиять на выполнение сразу нескольких критически важных бизнес-процессов. Поэтому требуется соответствующая архитектура, предусматривающая резервирование, отказоустойчивость и отсутствие единичных точек отказа, подчеркивает.
Большие перемены: релизы, миграции, импортозамещение
Третья группа рисков связана с плановыми, но сложными изменениями — и здесь банковский сектор оказался одним из самых чувствительных.
«По открытым данным, 38% крупных инцидентов в банках связаны с ИТ изменениями — релизами, миграциями, интеграциями. Поэтому критичны и защита, и управление изменениями: поэтапные релизы, автопроверки, возможность быстрого отката».
Александр Тоцкий,
руководитель департамента инфраструктуры и сопровождения систем «Совкомбанка»
Александр Сабуров добавляет, что переход на отечественное ПО, миграция данных, обновление платформ и внедрение новых технологий, включая решения на базе искусственного интеллекта, должны производиться так, чтобы банк работал без перебоев и не нарушал требования регуляторов.
Набор основных угроз универсален. Но оборачиваются эти угрозы разными последствиями. Для банка — остановкой платежей, для авиакомпании — сбоем в расписании полетов, для промышленности — остывшими печами и сорванными контрактами. И у каждого простоя — своя цена.
Как бизнес оценивает последствия инцидентов
Зачем оценивать последствия сбоев и инцидентов? Для начала — это требование регуляторов для ряда отраслей. Законодательство предписывает организациям количественно измерять риски, ущерб и время восстановления.
«Использование формул для подсчета рисков и оценки ущерба является прямым требованием нормативных актов. В частности, вступивший в силу 1 марта 2026 года Приказ ФСТЭК России № 117 вводит обязательную количественную методологию для этих целей. При оценке защищенности государственных информационных систем (ГИС) больше не применяются статичные классы. Вместо них вводится коэффициент защищенности информации (КЗИ) — числовой показатель от 0 до 1, который рассчитывается по строгой методике и применяется для того, чтобы оценить текущие риски в организации и принять меры по защите».
Сергей Левашов,
заместитель генерального директора по ИТ и цифровой трансформации Государственного научно-исследовательского института гражданской авиации
В основе оценки бизнес-последствий любых инцидентов — от кибератак до отключения электричества — лежит BIA (Business Impact Analysis). Это универсальный инструмент, который помогает измерить потенциальный ущерб от простоев критических процессов. С его помощью аналитики определяют, остановка каких процессов и как быстро причинит компании недопустимый ущерб, какие ресурсы, в том числе ИТ-активы, критичны для этих процессов.
Независимо от того, что вы оцениваете: последствия кибератаки, технического сбоя или ошибки персонала, — основой любого анализа станут три универсальные метрики.
MTPD (Maximum Tolerable Period of Disruption) — максимально допустимое время остановки процесса. Это самый жесткий показатель. Проще говоря, это «потолок» времени простоя. MTPD устанавливается руководством на основе анализа как минимум финансовых, репутационных и регуляторных последствий из-за простоя. Например, для платежного шлюза MTPD может исчисляться минутами, а для внутренней системы отчетности — часами.
RTO (Recovery Time Objective) — целевое время восстановления после инцидента. Критическое правило: RTO всегда должно быть меньше или равно MTPD.
RPO (Recovery Point Objective) — допустимая потеря данных (в пересчете на время). Этот показатель напрямую влияет на стратегию резервного копирования: если RPO составляет 15 минут, значит, бэкапы должны создаваться не реже чем каждые 15 минут.
Это не просто цифры в Excel. Эти метрики определяет BIA для каждого критического процесса, и российские компании активно их используют. Именно эти метрики, а не абстрактные суммы убытков ложатся в основу BCP: устанавливают, какие процессы резервировать в первую очередь, какие сроки восстановления закладывать в контракты и сколько инвестировать в защиту.
«RTO и RPO — это база, но нужно видеть всю цепочку зависимостей клиентского пути: сеть, ЦОД, API, поставщиков. Важнее измерять не доступность отдельных систем, а работоспособность пути в целом. Клиенту важно, что платеж прошел, а не где именно случился сбой. AIOps позволяет прогнозировать отказы заранее, сокращая реакцию с часов до секунд».
Александр Тоцкий,
руководитель департамента инфраструктуры и сопровождения систем «Совкомбанка»
В «Совкомбанке» считают стоимость часа простоя, вероятность инцидента, регуляторные и репутационные риски. А ИИ-аналитика выявляет нетривиальные корреляции между поведением пользователей и рисками сбоев, переводя абстрактные угрозы в конкретные финансовые показатели.
Как рассказал Дмитрий Деев, в компании «Ви.Тех» применяют детализированные матрицы, которые учитывают возможные убытки, критичность процессов, степень влияния и вероятность инцидентов.
Для расчета непосредственно стоимости простоя — независимо от его причины — используется модель TCoDT (Total Cost of Downtime).
TCoDT (за час) = Прямые денежные потери за час (Выручка + Зарплаты + Восстановление + Штрафы).
Дополнительно (риск-корректировка): репутационные потери и потеря лояльности рассчитываются отдельно как вероятностные отложенные убытки и прибавляются к годовой сумме риска, а не к часовой ставке.
Если рассматривать формулу более развернуто, получаем такую схему TCoDT:
- Потеря дохода: Годовая выручка / 525 600 минут в году × Количество минут простоя.
- Потери от простоя сотрудников: Средняя почасовая оплата × Количество сотрудников × Часы простоя × Коэффициент восстановления 1,4. Коэффициент 1,4 учитывает посткризисное падение продуктивности: после серьезного сбоя сотрудникам требуется в среднем 23 минуты, чтобы вернуть фокус.
- Затраты на восстановление — сколько потратили на зарплату специалистам, которые устраняли сбой, и на оборудование/услуги.
- Штрафы— штрафные санкции, которые компания выплачивает немедленно или в короткий срок: по SLA перед клиентами, за нарушение сроков восстановления, а также штрафы регуляторов (например, за недоступность сервисов).
- Потеря лояльности клиентов — часть клиентов может уйти к конкурентам. Потерю выручки умножаем на процент повторных продаж.
- Репутационные потери — негатив в соцсетях и на сайтах-отзовиках, из-за чего новые клиенты не придут. Потенциальную потерю клиентов умножаем на пожизненную ценность клиента.
Результат этих расчетов — это денежная оценка фактического простоя. Однако сами по себе эти цифры не дают ответа на вопрос, насколько эффективно компания управляет процессом восстановления. Поэтому на основе полученных данных и целевых показателей (RTO, RPO), определенных в ходе BIA, проводится GAP-анализ. Он позволяет сравнить фактическое положение дел (реальное время восстановления, фактические потери) с целевым (утвержденные RTO и RPO) и увидеть расхождения. Например, если фактическое среднее время восстановления (MTTR) систематически превышает целевой RTO, GAP-анализ покажет, где и насколько компания отклоняется от плана. Это становится основой для корректировки стратегий восстановления и пересмотра бюджетов на защиту.
Сергей Левашов подчеркивает, что каждая компания решает сама, как именно управлять рисками остановки бизнес-процессов. Например, кто-то закладывает бюджет на выплаты вымогателям за разблокировку, а кто-то полностью игнорирует возможность реализации ИБ-угроз. В то же время активно развивается рынок киберстрахования и страховые компании уже выплачивают пострадавшим серьезные суммы.
BCP: от цифр к действиям
Расчетная стоимость простоя помогает понять масштаб риска, но сама по себе не обеспечивает непрерывность. Даже зная, что час недоступности сервисов обходится бизнесу в миллионы рублей, компания не восстановит продажи, обслуживание клиентов или производство автоматически. Финансовые показатели должны превращаться в конкретные сценарии действий — именно эту задачу решает план обеспечения непрерывности бизнеса (Business Continuity Plan, BCP).
BCP — это документ, в котором определены конкретные шаги, осуществление которых позволит компании продолжать выполнять ключевые задачи во время сбоя и быстро вернуться в норму после него. По сути, это стратегическая инструкция, которая отвечает на главный вопрос: как мы будем работать, пока устраняем последствия проблемы?
Важно не путать BCP с планом аварийного восстановления (Disaster Recovery Plan, DRP). Их различия принципиальны:
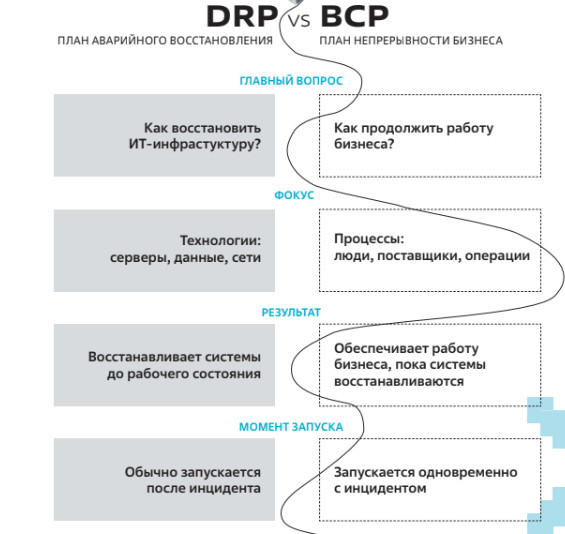
Другими словами, DRP восстанавливает ИТ, а BCP сохраняет бизнес. Если серверы вышли из строя, DRP описывает, как их поднять. BCP описывает, как сотрудники продолжат обрабатывать заказы вручную, куда они переедут работать и как объяснят клиентам задержки.
Содержание плана варьируется от компании к компании, но ключевые элементы остаются неизменными:
- кто, что и когда делает (ответственная команда, контакты);
- сценарии активации и работы (критерии активации BCP — например, если простой платежного шлюза превысил 10 минут; пошаговые и временные процедуры);
- ресурсы для работы в кризис (резервные офисы и поставщики);
- коммуникации (кто и в какие сроки информирует сотрудников, партнеров, клиентов, СМИ, регуляторов).
Разработка BCP — это не разовое мероприятие, а непрерывный процесс, состоящий из пяти этапов:
- Анализ. Выполняется BIA и оцениваются риски. Результаты BIA определяют критичные процессы и их MTPD/RTO/RPO, а оценка рисков — угрозы (кибератаки, отключения электричества, сбои поставщиков) для этих процессов.
- Разработка. На основе анализа создаются стратегии восстановления: резервирование мощностей, ручные обходные пути, переезд на альтернативные площадки. Формируется документ BCP с перечнем всех процедур и списком ответственных.
- Внедрение. План доводится до всех сотрудников, команды проходят обучение, вводятся регламенты, интегрирующие BCP в повседневные процессы.
- Тестирование. Проводятся учения: семинары, обсуждение сценариев за столом переговоров и полномасштабные симуляции с реальным переключением на резервные мощности. Тестирование выявляет слабые места плана.
- Актуализация. BCP — «живой» документ. Он пересматривается и обновляется при изменении бизнес-процессов, ИТ-архитектуры, ландшафта угроз или смене кадров.
Почему BCP обязателен: регуляторный контекст
О требованиях к количественной оценке рисков мы уже говорили выше в разделе о расчетах. Здесь же подчеркнем: для многих компаний BCP — не рекомендация, а обязанность. В первую очередь к BCP предъявляются требования в финансовой отрасли. Для банков это Приложение 5 к Положению Банка России № 242-П, которое устанавливает обязательные требования к непрерывности критических процессов: определение RTO/RPO для каждой системы, наличие и регулярное тестирование планов восстановления. Наряду с этим ЦБ планомерно развивает регуляторную базу в сфере операционной надежности, вводя новые требования к оценке зрелости BCP и переходя от формальной проверки документов к проверке их практической реализуемости.
Таким образом, BCP — это документ, который связывает количественную оценку рисков с конкретными управленческими решениями. На основе утвержденных RTO и RPO он определяет приоритеты восстановления, распределение ресурсов и зоны ответственности команд, обеспечивая предсказуемый выход из кризиса.
Самое сложное в построении работающей системы управления непрерывностью бизнеса не расчеты и не документы, а согласования и честный диалог с бизнесом. В начале пути критичным кажется всё, но после проведения честного BIA остается десяток процессов, остановка которых неминуемо приведет к недопустимым потерям выручки, уходу ключевых клиентов или проблемам с регулятором.
Многие на практике пытаются закрыть этот вопрос резервированием всего, что только можно, но сталкиваются с опасным заблуждением: «У нас есть резервный ЦОД, значит мы защищены». Непрерывность куда шире вопроса «Как быстро поднять ключевые системы», потому что вопросы «А кто будет принимать решение о переключении в 3 часа ночи», «Как сотрудники будут принимать заказы первое время» и «Что мы скажем клиентам в первые полчаса» не менее важны, и только комплексный подход делает компанию по-настоящему готовой к любой катастрофе и сбою.
Что же можно предпринять в первую очередь? Я бы выделил эти простые шаги, с которых надо начать:
- Определить, что для компании является недопустимым ущербом;
- Выделить 8–10 процессов с недопустимым ущербом за кратчайшее время простоя;
- Зафиксировать для каждого MTPD, RTO и RPO в числовых значениях, а не в виде формулировки «как можно быстрее»;
- Описать зависимости: люди, системы, площадки, подрядчики. Кстати, очень часто на данном этапе выясняется, что главный риск для процесса — увольнение инженера, знающего все нюансы работы, или находится поставщик, у которого нет альтернативы;
- Взять один сценарий и провести по нему настольные учения с участием топ-менеджмента.
После такой работы план начнет расти сам: учения покажут, чего в нем не хватает. И это будет гораздо продуктивнее, чем бесконечная разработка идеального документа.
Аскар Мусаев,
эксперт по непрерывности бизнеса компании «Инфосистемы Джет»