Связаться с редакцией


По нашему проектному опыту, сегодня лишь примерно в одной компании из двадцати существует полноценный план аварийного восстановления и только небольшой процент компаний из этого числа регулярно проверяют возможности его применения. Между тем любой серьезный сбой в ИТ-инфраструктуре влечет за собой не только технические проблемы, но и финансовые потери — из-за простоев, нарушения обязательств перед клиентами и репутационного ущерба. Объем убытков напрямую связан со скоростью возвращения ИТ-систем в рабочее состояние, которая зависит от того, как команда будет действовать в случае инцидента: хаотично или по заранее подготовленным и отработанным сценариям. А при кибератаке любое промедление и вовсе может стать фатальным.
Как продолжать взаимодействовать с клиентами, предоставлять услуги, проводить оплату и выполнять другие контрактные и социальные обязательства, если бизнес-системы и ИТ-инфраструктура «лежат» после инцидента? А ведь пока не восстановлена работа баз данных, приложений (включая смежные системы), каналов связи или корпоративных сервисов, полноценно возобновить деятельность компании невозможно.
Сегодня почти любой бизнес-процесс зависит от технологий. И стоимость простоя ИТ-систем в отдельных отраслях достигает миллионов долларов в час: для финансовых сервисов — 5–9 млн долл., для E-commerce-компаний — 2–4 млн долл. А на производстве последствия могут быть еще серьезнее: остановка технологических линий способна привести к срыву поставок, остановке отгрузок и приемки. В итоге — потеря репутации, уход клиентов и более печальные исходы.
За быстрое возвращение к работе ИТ-систем отвечает план аварийного восстановления (Disaster Recovery Plan, DRP) — это один из ключевых инструментов планирования непрерывности бизнеса (Business Continuity Plan, BCP). Оба плана взаимосвязаны, и их правильно организованная реализация обеспечивает выживание компании при значительном происшествии.
DRP и BCP не стоит смешивать — это разные документы. BCP описывает восстановление бизнес- и производственных процессов и ИТ-инфраструктуры обычно никак не касается. А DRP — это план восстановления информационных систем, то есть он целиком фокусируется на ИТ-составляющей бизнес-процесса.
Если затраты на DRP меньше потенциальных потерь за два-три дня простоя, то это не расход, а страховка для бизнеса. Компании тратят миллионы на железо и лицензии, но экономят на разработке регламентов, хотя именно регламенты минимизируют время восстановления.
Какие инциденты требуют запуска DRP
DR-план — это набор регламентов и сценариев, определяющих порядок восстановления ИТ-систем после серьезного инцидента. При этом важно понимать, что он охватывает не все технические сбои, которые могут затронуть инфраструктуру. На практике механизмы аварийного восстановления и отказоустойчивости нередко смешивают, хотя они решают разные задачи.
Например, выход из строя блока питания, отказ диска или контроллера в системе хранения данных, потеря канала связи или недоступность одного из узлов кластера высокой доступности (High Availability, HA)еще не означают необходимость запускать механизмы DRP.
Эти сценарии относятся к обеспечению высокой доступности. Задача HA заключается в том, чтобы локальный отказ отдельного компонента не привел к остановке сервисов. Если один из них выходит из строя, его нагрузку принимает соседний. При отказе одного канала связи трафик автоматически переключается на резервный маршрут, а при сбое экземпляра приложения система оркестрации запускает новый. В идеале пользователь даже не замечает, что произошел какой-то сбой.
Disaster Recovery же начинается там, где возможностей отказоустойчивой архитектуры уже недостаточно. Когда автоматическое переключение не помогает, сервисы останавливаются, а для их восстановления требуется приглашать специалистов, принимать решения на высоком уровне и выполнять заранее подготовленный план. Именно в этом принципиальная разница.
Кто запускает DRP? В критической ситуации решение о запуске плана восстановления должен принимать CEO или лицо, указанное в DRP. Кратковременный простой, связанный с ручным переключением на резервный ЦОД, в таких условиях может обойтись компании дешевле, чем бездействие и ожидание того, что автоматические механизмы справятся с проблемой самостоятельно. Поэтому важно заранее определить список людей, принимающих решение.
Примеры сценариев, способных повлечь остановку сервисов и попадающих в область действия плана аварийного восстановления:
- потеря работоспособности площадки (из-за взрыва, пожара, потопа, обесточивания, аварийного отказа кондиционирования, других сбоев инженерных систем и т. д.);
- авария на линиях связи, в сети, нарушение корректной работы сети;
- авария на ключевом вычислительном или коммуникационном оборудовании площадки;
- отказ кластера без автоматического механизма резервирования (HA);
- заражение инфраструктуры вирусом-шифровальщиком, взлом, проникновение посторонних лиц в ЦОД;
- отказ ПО, на котором работает сервис (баг, ошибка обновления, повреждение данных и т. д.);
- отказ смежной ИС (невозможность получить данные и, как следствие, остановка сервиса);
- любая другая авария, регламентное решение которой выходит за пределы допустимых RTO (Recovery Time Objective) и RPO (Recovery Point Objective), — например, отказ компонентов, не покрытых HA (даже если это блок питания, но он один и сервер единственный);
- нарушение балансировки нагрузки — неконтролируемое или по неясным причинам (например, возможная DDoS-атака или отказ балансировщиков).
DRP не применяется в следующих случаях:
- падение плеча автоматического HA-кластера active-active (несколько узлов одновременно обслуживают нагрузку), active-passive (один узел работает, второй — находится в резерве и включается при отказе основного);
- отказ компонентов оборудования, не влекущий остановку сервисов;
- отказ компонентов, приводящий к остановке сервиса, однако устранение проблемы укладывается в допустимые показатели RTO и RPO (например, если вышел из строя единственный блок питания, а его замена занимает несколько минут);
- нарушение балансировки нагрузки, не требующее переключения на резервную площадку;
- действия, выполняемые после переезда сервисов на резервную площадку: выяснение причин, восстановление работоспособности основной площадки, возврат сервисов обратно.
Действия в случаях локальных отказов должны быть описаны в инструкции ИТ-администратора.
Когда главным риском стала кибератака
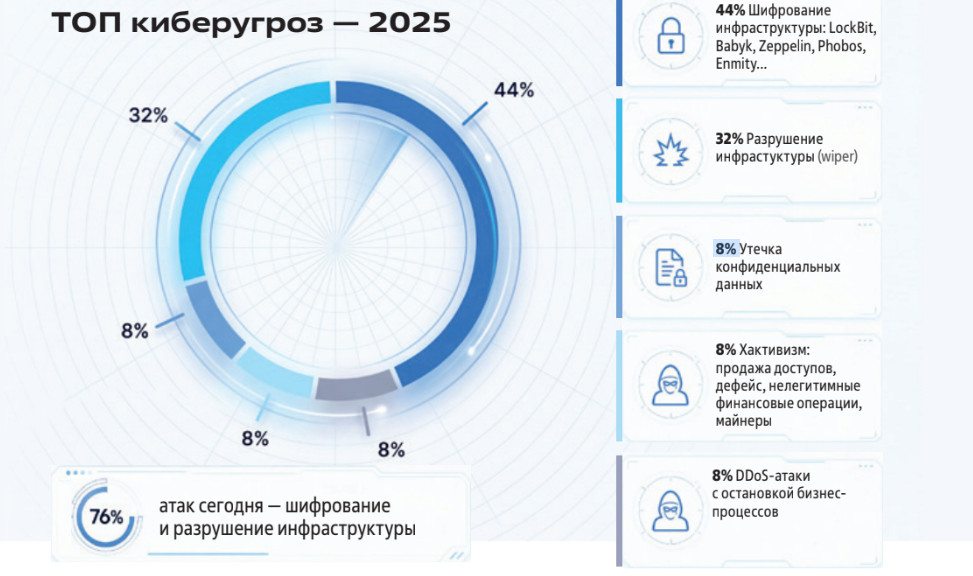
Если раньше основными причинами запуска аварийного восстановления считались пожар в серверной, потеря питания или отказ оборудования, то в последние годы ими стали кибератаки. Причем их цели тоже изменились: кража информации как таковой теперь интересует преступников все реже.
По данным исследования Jet CSIRT, посвященного популярным тактикам и техникам нарушения киберустойчивости российских компаний, цель 76% всех атак — остановить бизнес. Для этого злоумышленники используют программы-вайперы (вредоносное ПО для уничтожения данных). Соответственно, меняется и роль резервной площадки — взломщики проникают и в ее инфраструктуру. Поэтому простое переключение на резервный ЦОД уже не гарантирует успешного восстановления.
Вместе с тем использование кибератак вынуждает менять и саму последовательность аварийного восстановления. Если при пожаре, отказе оборудования или другой физической аварии главная задача — как можно быстрее вернуть систему в работу, то после взлома этого уже недостаточно. Прежде чем запускать сервисы, необходимо убедиться в том, что инфраструктура очищена от последствий компрометации и злоумышленник больше не имеет к ней доступа. Иными словами, восстановление после киберинцидента — это уже не возврат к состоянию «как было», а контролируемый процесс построения доверенной среды.
Сначала — лабораторная чистота
Восстановление после кибератаки начинается не с запуска сервисов, а с проверки так называемой лабораторной чистоты инфраструктуры, данных и систем. То есть, прежде чем возвращать системы в работу, необходимо убедиться в том, что вредоносное ПО полностью удалено, механизмы закрепления злоумышленника устранены, а резервные копии действительно безопасны для восстановления.
Удостоверившись в том, что данные не заражены, можно переходить ко второму этапу — восстановлению сервисов в изолированном контуре. И только затем — постепенно возвращать системы в эксплуатацию.
Есть еще одно важное отличие. Последствия физической аварии, как правило, ограничены самим событием. Киберинцидент же может развиваться даже после его обнаружения, потому что преступники иногда месяцами находятся в инфраструктуре и закрепляются в ней, что увеличивает возможный масштаб компрометации и усложняет процесс восстановления. Пока компания анализирует ситуацию, злоумышленники продолжают перемещаться по инфраструктуре. Поэтому действовать приходится зачастую намного быстрее, чем при классической аварии, — ведь каждая потерянная минута увеличивает потенциальный ущерб.
Отсюда следует важный вывод: процедуры восстановления после кибератаки и после классической аварии — совершенно разные. Меняется все: от подготовки резервных копий до последовательности запуска сервисов и критериев готовности инфраструктуры к возвращению в эксплуатацию. Поэтому современные DR-планы все чаще разрабатываются с учетом того, что главная чрезвычайная ситуация для бизнеса — не отказ оборудования из-за технических сбоев и аварий, а компрометация инфраструктуры злоумышленниками.
DRP, который никогда не работал
Наличие DR-плана само по себе и готовность к восстановлению — далеко не одно и то же. Лишь немногие компании успешно проходят реальный инцидент. На практике часто оказывается, что под DR-планом понимается что угодно: набор инструкций от вендоров, несколько страниц в корпоративной базе знаний или таблица с контактами сотрудников на случай ЧП.
Одна из главных проблем заключается в том, что компании имеют расплывчатое представление о собственной инфраструктуре. За годы развития ИТ-ландшафт обрастает новыми системами, интеграциями и сервисами, а изменения в документацию вовремя не вносят. В результате в критический момент выясняется, что никто не может быстро ответить на простые вопросы: какой сервер за что отвечает, где находятся резервные копии, какие сервисы зависят друг от друга, кого необходимо подключить к восстановлению и что вообще нужно запускать в первую очередь.
Ситуацию усугубляет и то, что значительная часть критически важных знаний хранится не в документации, а в головах сотрудников. Пока все работает в штатном режиме, это редко приводит к проблемам. Однако во время серьезного инцидента внезапно оказывается, что:
- ключевой специалист находится в отпуске;
- архитектор уволился;
- сбой тестового сервера серьезно влияет на промышленную среду;
- многие зависимости между сервисами никогда не фиксировались должным образом.
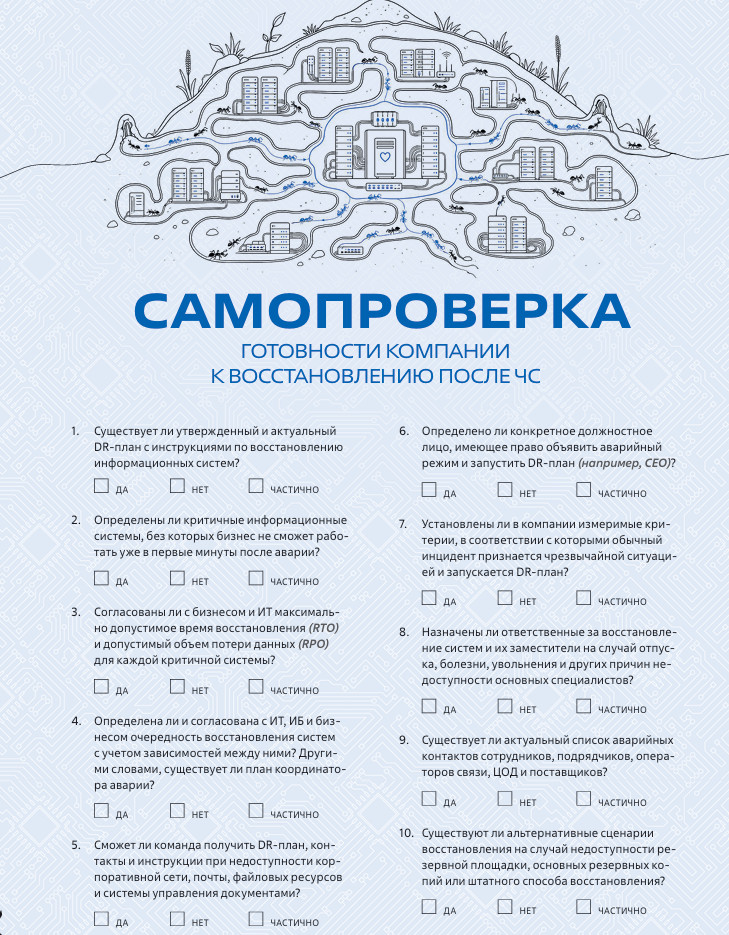
Даже существующие DR-планы очень часто не проверяются на практике. А ведь DRP — это не PDF-файл и не набор инструкций в корпоративной базе знаний.
Это навык команды восстанавливать инфраструктуру в условиях кризиса — сегодня это фактически один из важнейших ИТ-процессов. А любой навык требует закрепления — то есть регулярной практики.
Зрелый DR-план — это не только документ, но и регулярные учения, актуализация после изменений в инфраструктуре и постоянная проверка выполнимости каждого шага. Любое изменение архитектуры, внедрение нового сервиса или перенос системы на другую платформу могут сделать часть плана неактуальной. Поэтому даже развитая инфраструктура отказоустойчивости сама по себе не гарантирует готовности к восстановлению. Согласно данным исследования компании «Инфосистемы Джет» по оценке уровня зрелости ИТ-инфраструктуры российских компаний, около 60% предприятий используют локальные средства высокой доступности, 48% применяют глобальную кластеризацию и резервный ЦОД с автоматизацией переключения. При этом более четверти владельцев РЦОД не проводят DR-тесты, а значит, их DRP со временем теряют практическую эффективность.
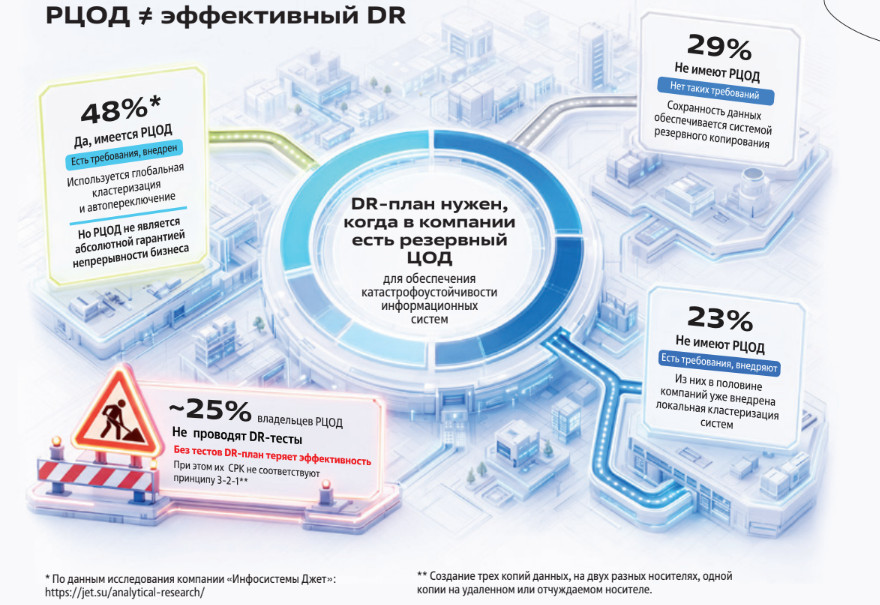
Только тестирование позволяет увидеть объективную картину. Лишь оно показывает реальное время восстановления RTO, реальные зависимости между системами, реальные узкие места инфраструктуры и реальные проблемы коммуникации внутри команды. Более того, именно во время проверок обычно обнаруживаются ошибки в последовательности действий, которая на бумаге выглядит абсолютно логичной.
На практике разрыв между плановым и реальным RTO может быть очень заметным. Согласно статистике компании «Инфосистемы Джет», среднее время восстановления критичных бизнес-процессов составляет 15,4 рабочего дня, а в крупных организациях может достигать 38 дней. В отдельных случаях компании не возвращаются к полноценной работе даже спустя год после инцидента.
Инфраструктура почти никогда не восстанавливается так, как это нарисовано на схемах. В документации процесс выглядит линейным и предсказуемым, однако во время тестирования выясняется, что:
- один сервис зависит от другого;
- запуск отдельного компонента требует дополнительных условий;
- часть критически важных связей нигде не зафиксирована.
Поэтому зрелый DRP — это всегда цикл: аудит, разработка плана, тестирование, корректировка, учения, актуализация и снова тестирование.
Приведем показательный пример из практики. Во время восстановления финансовой компании после масштабного инцидента выяснилось, что их DR-план не учитывал зависимость ключевых банковских систем от смежных компонентов, в том числе от инфраструктурных сервисов. В результате восстановление, которое должно было занять около двух часов, растянулось почти на сутки.
Форматы проверок могут быть разными. Самый простой вариант — tabletop-учения, когда команда пошагово разбирает сценарий аварии и свои действия. Следующий уровень — вычитка плана по ролям. Это помогает обнаружить устаревшие сведения, неучтенные зависимости и ошибки в распределении ответственности.
Наиболее приближенным к реальности сценарием является тестовое восстановление в отдельной среде, где команда может проверить работоспособность плана без риска для продуктивной инфраструктуры. Для бизнес-критичных систем такие проверки желательно проводить не реже одного раза в полгода.
Бутылочное горлышко аварийного восстановления
Согласно теории управления процессами, бутылочное горлышко — это участок, который ограничивает скорость работы всей системы. Когда речь заходит о DRP, основное внимание обычно уделяют технологиям, однако практика показывает, что узкое место в процессе любого восстановления создают не особенности инфраструктуры, а люди. Именно от их решений, координации действий и скорости реакции зависит, насколько быстро компания сможет вернуться к работе.
С ростом числа кибератак, когда возвращение систем к работе перестало быть исключительно внутренней задачей ИТ и превратилось в задачу бизнеса, круг участников процесса восстановления расширился.
Теперь, помимо ИТ-специалистов, в него вовлекаются руководители компании, начальники профильных подразделений, специалисты по ИБ и другие заинтересованные стороны. В ряде случаев именно высшее руководство должно принять решение о временной остановке систем, чтобы не допустить еще большего ущерба.
По этой причине в зрелых организациях заранее формируется кризисный штаб и распределяются роли всех участников восстановления. В DR-плане должно быть четко определено, кто принимает решение о запуске аварийного режима, кто отвечает за восстановление инфраструктуры, кто координирует работу команд и кто взаимодействует с руководством и бизнесом.
Во время кризиса люди не должны думать, что делать. Они должны выполнять заранее отработанные роли. Без такой подготовки даже идеально написанный DRP — бесполезный документ.
Универсального рецепта не существует
После знакомства с принципами аварийного восстановления у многих может возникнуть соблазн найти универсальный шаблон DR-плана и адаптировать его под свои задачи. Тут важно понимать, что DRP, подходящего для всех компаний, не существует.
Сценарий восстановления всегда определяется особенностями конкретной компании: ИТ-архитектурой, перечнем критически важных сервисов, требованиями к непрерывности бизнеса, в том числе регуляторными, и допустимым уровнем риска. Поэтому каждая организация выстраивает план с учетом собственных процессов, технологий и приоритетов.
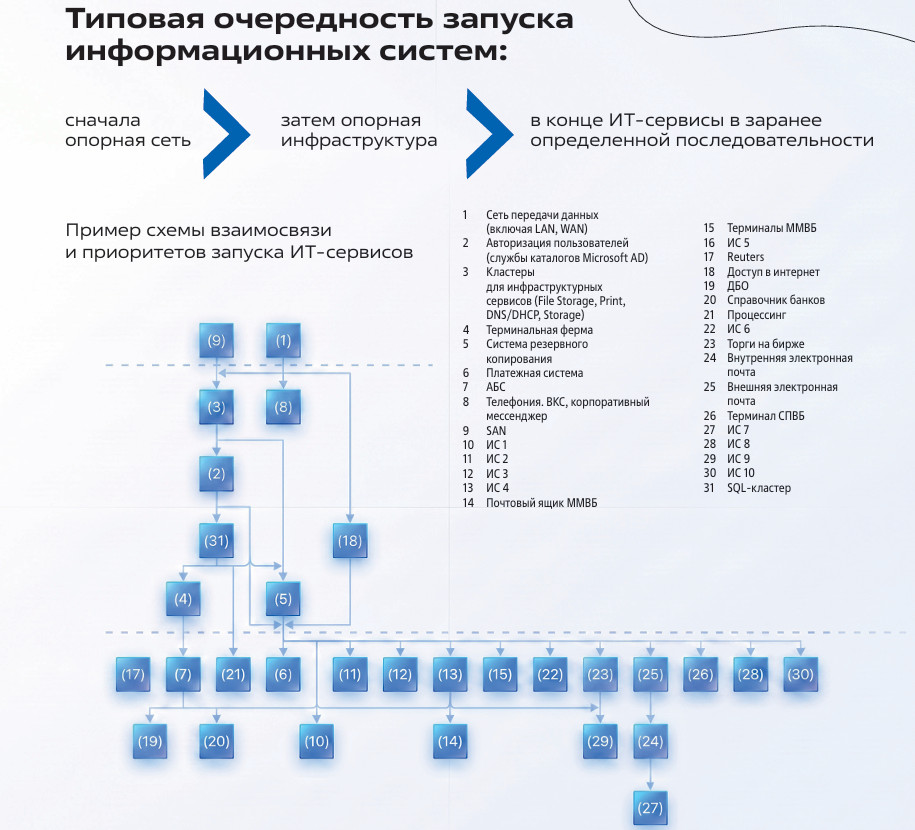
Более того, внутри одной организации не бывает единого сценария восстановления для всех систем. Каждая критичная для бизнеса система имеет собственные зависимости, приоритеты и порядок запуска. Общий DRP должен включать множество DR-планов — для каждой из систем, а также очередность их восстановления и условия, при которых команда переходит к следующему этапу.
Это особенно важно, потому что во время реального инцидента ресурсы всегда ограниченны. Времени мало, часть специалистов может быть недоступна, а выполнять все работы одновременно невозможно. Если приоритеты не определены заранее, команда начинает восстанавливать те системы, с которыми проще или привычнее работать, а не те, от которых непрерывность бизнеса зависит в первую очередь.
В конечном итоге качество DR-плана определяется не объемом документации и не количеством схем. Единственный универсальный критерий остается неизменным: если план ни разу не проверяли на практике, его не существует.
Что должно быть в DRP
Матрица ролей:
- кто принимает решения о запуске восстановления;
- кто отвечает за инфраструктуру;
- кто отвечает за резервное копирование;
- кто взаимодействует с ИБ;
- кто выполняет шаги по восстановлению систем.
Матрица коммуникаций:
- кого оповещать и в каком порядке;
- резервные контакты;
- замещающие сотрудники.
Пошаговые инструкции:
- порядок выполнения технологических шагов;
- ориентировочные временные интервалы;
- приоритеты выполнения операций;
- критерии перехода между шагами DRP;
- зависимости между операциями;
- проверки успешности выполнения восстановления систем.